Autores
Philip Zetterberg
Ingeniero de software de IA, TRENPEX
Colaboradores
Angie Zetterberg
Relaciones públicas, TRENPEX
Suscríbanse a nuestro boletín informativo
Compartir
Del reconocimiento de signos individuales a la comprensión de las relaciones entre ellos
Una cámara capta un vagón de mercancías que pasa por delante. En la imagen se aprecian el número de matrícula, las inscripciones técnicas, los componentes y, posiblemente, un contenedor. Para una persona, suele resultar evidente de inmediato qué información corresponde a cada objeto. Para un sistema informático, esto supuso durante mucho tiempo varias tareas independientes.
El reconocimiento de texto, también denominado «Optical Character Recognition» (OCR, por sus siglas en inglés), lee, por ejemplo, una matrícula. La clasificación de imágenes asigna el vehículo a una categoría. Un modelo de detección localiza determinados componentes en la imagen. Estos procedimientos especializados pueden llevar a cabo su tarea respectiva de forma muy eficiente. Sin embargo, la cuestión de cómo se relacionan entre sí las informaciones reconocidas suele tener que resolverse mediante reglas o programas informáticos adicionales.
Aquí es donde entran en juego los modelos de visión y lenguaje (VLM, por sus siglas en inglés). Estos modelos relacionan la información visual con el lenguaje. De este modo, un sistema no solo puede buscar un número, sino también responder, por ejemplo, a la pregunta: «¿Qué número corresponde al contenedor que se encuentra en el vagón delantero?»
Por lo tanto, la diferencia no radica tanto en que se proceseunaimagen, sino en qué preguntas pueden plantearse sobre dicha imagen.
¿Qué es un modelo de visión y lenguaje?
Un modelo «Vision-Language» es un modelo de inteligencia artificial que procesa conjuntamente información visual y lingüística. En términos sencillos, combina dos capacidades: es capaz de detectar características en una imagen y relacionarlas con términos, preguntas o descripciones.
Para ello, la imagen se traduce en primer lugar a un formato con el que pueda trabajar una red neuronal. Un denominado «codificador de visión» reconoce, por ejemplo, formas, patrones y estructuras espaciales. Se le puede considerar como el sistema de percepción visual del modelo. A continuación, un modelo de lenguaje vinculado a las características de la imagen procesa la pregunta formulada y genera una respuesta adecuada. La implementación técnica concreta varía de un modelo a otro. [1–4]
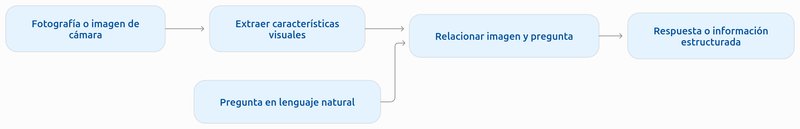
El avance decisivo radica en la flexibilidad. Mientras que para una tarea de reconocimiento clásica suele ser necesario un modelo entrenado específicamente o una cadena de procesamiento definida de forma fija, con un VLM adecuado es posible describir diferentes tareas mediante el lenguaje. Por ejemplo, primero se puede preguntar por el tipo de un objeto y, a continuación, por su etiqueta o su estado visible.
Esto no significa que el modelo «vea» como un ser humano o que lo comprenda todo correctamente. Utiliza las relaciones que ha aprendido durante el entrenamiento. No obstante, este enfoque abre posibilidades que van más allá del mero reconocimiento de objetos.
Por qué el contexto está transformando el procesamiento de imágenes
Esta ventaja resulta especialmente evidente en el reconocimiento de texto. El OCR clásico debe reproducir con la mayor precisión posible los caracteres que aparecen en una imagen. Esto resulta indispensable para números de identificación, etiquetas o inscripciones técnicas. Sin embargo, el OCR por sí solo no sabe necesariamente qué significado tiene el texto de la imagen.
Además, un VLM puede tener en cuenta la relación entre el texto y su entorno. Si en una placa de características figuran varios valores, puede intentar encontrar el valor adecuado para responder a la pregunta «¿Cuál es la potencia indicada?». Al realizar un registro del vehículo, puede analizar conjuntamente las distintas marcas y su ubicación espacial.
De este modo, la tarea cambia: en lugar de «Lea este texto», pasa a ser «Encuentre la información que necesito y asigne cada dato a su lugar correcto». Los trabajos de investigación sobre preguntas basadas en imágenes y sobre la comprensión de documentos muestran cómo se pueden utilizar conjuntamente el texto, el diseño y las características visuales para ello. [6, 7]
Esto resulta interesante también más allá del texto. Por ejemplo, a un VLM se le puede preguntar por componentes visibles, su relación entre sí o aspectos llamativos de la imagen. Además, los métodos basados en el lenguaje para el reconocimiento de categorías de objetos abiertas demuestran que no todas las categorías tienen que estar necesariamente definidas desde el principio en una lista fija. La posibilidad de identificar una nueva categoría únicamente a partir de su descripción ofrece una base mucho más flexible para futuras aplicaciones. [2, 8]
Nuevas posibilidades para aplicaciones industriales
En el procesamiento industrial de imágenes, rara vez se trata únicamente de un único objeto. Las imágenes suelen contener gran cantidad de información que solo resulta útil en su contexto: ¿Qué unidad se ve? ¿A qué número corresponde? ¿Qué componentes hay? ¿Hay alguna característica destacada visible?
En este sentido, los VLM abren nuevas posibilidades: pueden establecer relaciones entre distintos datos dentro de una imagen y responder a preguntas que van más allá del mero reconocimiento de características individuales. Así, por ejemplo, en el caso de una instalación industrial, no solo se puede preguntar qué componentes son visibles, sino también cómo se disponen espacialmente entre sí o qué indicios ofrece la imagen sobre el estado de la instalación. Asimismo, la información procedente de documentos, letreros o interfaces de usuario puede analizarse con mayor profundidad en su contexto respectivo.
Esta capacidad resulta especialmente interesante en aquellos casos en los que las imágenes presentan un aspecto muy variado y las necesidades de información cambian con el paso del tiempo. Las preguntas formuladas en lenguaje natural ofrecen un acceso más flexible a los datos visuales que el que permiten las categorías de reconocimiento fijas. De este modo, surgen nuevas oportunidades para el análisis, la documentación y el apoyo a los procesos industriales, sin que sea necesario definir de antemano y con todo detalle cada posible aplicación.
Allí donde la precisión sigue siendo fundamental
Estas capacidades adicionales no implican que los VLM superen automáticamente a todos los métodos utilizados hasta ahora. Un modelo puede describir una escena con precisión y, aun así, pasar por alto un solo dígito. En el caso de un número de identificación técnico, basta con que se reconozca incorrectamente un solo carácter para que ello resulte relevante.
Incluso en el caso de textos muy pequeños, imágenes borrosas, condiciones de iluminación variables o perspectivas poco habituales, la calidad de la imagen sigue siendo fundamental. Estudios recientes sobre el reconocimiento multimodal de texto y su robustez ponen de manifiesto que dichos retos siguen existiendo. [9–12]
A esto hay que añadir que un modelo generativo puede formular una respuesta convincente, pero errónea —por ejemplo, mencionar una característica que ni siquiera se aprecia en la imagen—. Este fenómeno se denomina «alucinación». Por ello, las afirmaciones técnicas en las que se basan otros procesos deben seguir siendo verificables. [9]
Por último, el procesamiento de un modelo de mayor tamaño suele requerir una mayor potencia de cálculo que el de una red de reconocimiento pequeña y optimizada para una tarea concreta. En aplicaciones en las que el tiempo es un factor crítico o en dispositivos con una potencia de cálculo limitada, este es un criterio de selección importante. [3, 4]
Perspectivas: Combinar los puntos fuertes de ambos enfoques
La perspectiva más interesante no consiste necesariamente en sustituir todos los procedimientos existentes por un único modelo. Más bien, la detección especializada y la interpretación flexible de imágenes pueden complementarse entre sí.
Un modelo optimizado para ello podría seguir leyendo un número de identificación de forma rápida y precisa. Además, un VLM podría combinar información procedente de diferentes zonas de la imagen, responder a nuevas preguntas o describir situaciones inusuales. Posteriormente, una serie de comprobaciones técnicas garantizan que solo se incorporen a los procesos automatizados los datos que sean suficientemente fiables.
De este modo, la visión artificial está pasando del reconocimiento de características aisladas a la obtención de información visual en contexto. Para la industria, se trata de una perspectiva especialmente interesante: las imágenes de las cámaras no solo se convierten en una fuente de valores de medición o identificadores aislados, sino que pueden analizarse de forma cada vez más flexible en función de la información que un proceso realmente necesita.
Por lo tanto, los modelos de «Vision-Language» no suponen un adiós al procesamiento clásico de imágenes. Constituyen el siguiente paso hacia sistemas capaces de extraer más información de las imágenes y que, junto con procedimientos especializados, abren nuevas posibilidades para la automatización industrial.
Referencias
¹Dosovitskiy, A. et al. (2021). An Image Is Worth 16×16 Words: Transformers for Image Recognition at Scale. ICLR. https://arxiv.org/abs/2010.11929
²Radford, A. et al. (2021). Learning Transferable Visual Models From Natural Language Supervision. ICML. https://arxiv.org/abs/2103.00020
³Li, J. et al. (2023). BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models. ICML. https://arxiv.org/abs/2301.12597
⁴Liu, H. et al. (2023). Visual Instruction Tuning. NeurIPS. https://arxiv.org/abs/2304.08485
⁵Shi, B., Bai, X. & Yao, C. (2017). An End-to-End Trainable Neural Network for Image-Based Sequence Recognition and Its Application to Scene Text Recognition. IEEE TPAMI. https://doi.org/10.1109/TPAMI.2016.2646371
⁶Singh, A. et al. (2019). Towards VQA Models That Can Read. CVPR. https://arxiv.org/abs/1904.08920
⁷Kim, G. et al. (2022). OCR-free Document Understanding Transformer. ECCV. https://arxiv.org/abs/2111.15664
⁸Minderer, M. et al. (2022). Simple Open-Vocabulary Object Detection with Vision Transformers. ECCV. https://arxiv.org/abs/2205.06230
⁹Li, Y. et al. (2023). Evaluating Object Hallucination in Large Vision-Language Models. EMNLP. https://arxiv.org/abs/2305.10355
¹⁰Fu, L. et al. (2025). OCRBench v2: An Improved Benchmark for Evaluating Large Multimodal Models on Visual Text Localization and Reasoning. NeurIPS. https://arxiv.org/abs/2501.00321
¹¹Shi, B. et al. (2025). Scaling Vision Pre-Training to 4K Resolution. CVPR. https://arxiv.org/abs/2503.19903
¹²Saxena, R., Suglia, A. & Minervini, P. (2026). VLM-RobustBench: A Comprehensive Benchmark for Robustness of Vision-Language Models. https://arxiv.org/abs/2603.06148