Autoren
Philip Zetterberg
Software AI Engineer, TRENPEX
Mitwirkende
Angie Zetterberg
Public Relations, TRENPEX
Abonnieren Sie unseren Newsletter
Teilen
Vom Erkennen einzelner Zeichen zum Verstehen von Zusammenhängen
Eine Kamera erfasst einen vorbeifahrenden Güterwagen. Auf dem Bild sind eine Fahrzeugnummer, technische Anschriften, Bauteile und möglicherweise ein Container zu sehen. Für einen Menschen ist häufig unmittelbar nachvollziehbar, welche Information zu welchem Objekt gehört. Für ein Computersystem waren das lange Zeit mehrere getrennte Aufgaben.
Eine Texterkennung, auch Optical Character Recognition (kurz: OCR) genannt, liest beispielsweise eine Fahrzeugnummer. Eine Bildklassifikation ordnet das Fahrzeug einer Kategorie zu. Ein Detektionsmodell findet bestimmte Bauteile im Bild. Solche spezialisierten Verfahren können ihre jeweilige Aufgabe sehr effizient erfüllen. Die Frage, wie die erkannten Informationen zusammenhängen, muss jedoch häufig durch zusätzliche Regeln oder Software beantwortet werden.
Hier setzen Vision-Language-Modelle (kurz: VLMs) an. Sie verknüpfen Bildinformationen mit Sprache. Ein System kann dadurch nicht nur nach einer Nummer suchen, sondern beispielsweise die Frage bearbeiten: „Welche Nummer gehört zu dem Container auf dem vorderen Wagen?“
Der Unterschied liegt also weniger darin, dass ein Bild verarbeitet wird, sondern darin, welche Fragen sich an dieses Bild stellen lassen.
Was ist ein Vision-Language-Modell?
Ein Vision-Language-Modell ist ein KI-Modell, das visuelle und sprachliche Informationen gemeinsam verarbeitet. Vereinfacht kombiniert es zwei Fähigkeiten: Es kann Merkmale in einem Bild erfassen und diese mit Begriffen, Fragen oder Beschreibungen in Beziehung setzen.
Dazu wird das Bild zunächst in eine Form übersetzt, mit der ein neuronales Netz arbeiten kann. Ein sogenannter Vision Encoder erkennt dabei beispielsweise Formen, Muster und räumliche Strukturen. Man kann ihn sich als das visuelle Wahrnehmungssystem des Modells vorstellen. Ein mit den Bildmerkmalen verbundenes Sprachmodell verarbeitet dann die gestellte Frage und erzeugt eine passende Antwort. Die konkrete technische Umsetzung unterscheidet sich von Modell zu Modell. [1–4]
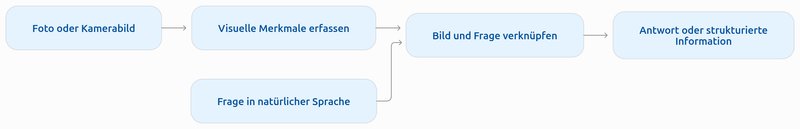
Der entscheidende Fortschritt ist die Flexibilität. Während für eine klassische Erkennungsaufgabe häufig ein speziell trainiertes Modell oder eine fest definierte Verarbeitungskette benötigt wird, lassen sich mit einem geeigneten VLM unterschiedliche Aufgaben sprachlich beschreiben. Beispielsweise kann man zunächst nach dem Typ eines Objekts fragen und anschließend nach seiner Beschriftung oder seinem sichtbaren Zustand.
Das bedeutet nicht, dass das Modell wie ein Mensch „sieht“ oder alles richtig versteht. Es nutzt Zusammenhänge, die es während des Trainings gelernt hat. Dennoch eröffnet dieser Ansatz Möglichkeiten, die über die reine Objekterkennung hinausgehen.
Warum Kontext die Bildverarbeitung verändert
Besonders anschaulich wird der Vorteil bei der Texterkennung. Klassische OCR soll möglichst genau wiedergeben, welche Zeichen auf einem Bild stehen. Das ist für Identifikationsnummern, Etiketten oder technische Anschriften unverzichtbar. Die OCR allein weiß aber nicht unbedingt, welche Bedeutung der Text im Bild besitzt.
Ein VLM kann zusätzlich die Beziehung zwischen Schrift und Umgebung berücksichtigen. Stehen auf einem Typenschild mehrere Werte, kann es versuchen, den passenden Wert zur Frage „Wie hoch ist die angegebene Leistung?“ zu finden. Bei einer Fahrzeugaufnahme kann es verschiedene Kennzeichnungen und ihre räumliche Zuordnung gemeinsam betrachten.
Damit verändert sich die Aufgabe: Aus „Lies diesen Text“ wird „Finde die Information, die ich brauche, und ordne sie richtig zu“. Forschungsarbeiten zu bildbasierten Fragen und zum Dokumentverständnis zeigen, wie Text, Layout und visuelle Merkmale dafür gemeinsam verwendet werden können. [6, 7]
Auch jenseits der Schrift ist das interessant. Ein VLM kann beispielsweise nach sichtbaren Komponenten, ihrem Verhältnis zueinander oder Auffälligkeiten im Bild gefragt werden. Sprachgestützte Verfahren zur Erkennung offener Objektkategorien zeigen zudem, dass nicht jede Kategorie zwingend von Anfang an in einer festen Liste hinterlegt sein muss. Eine neue Kategorie nur durch ihre Beschreibung ansprechen zu können, bietet eine deutlich flexiblere Grundlage für zukünftige Anwendungen. [2, 8]
Neue Möglichkeiten für industrielle Anwendungen
In der industriellen Bildverarbeitung geht es selten nur um ein einzelnes Objekt. Bilder enthalten oft zahlreiche Informationen, die erst im Zusammenhang nützlich werden: Welche Einheit ist zu sehen? Welche Nummer gehört dazu? Welche Bauteile sind vorhanden? Gibt es eine sichtbare Besonderheit?
Hier eröffnen VLMs neue Möglichkeiten: Sie können unterschiedliche Informationen innerhalb einer Aufnahme in Beziehung setzen und auf Fragen reagieren, die über das bloße Erkennen einzelner Merkmale hinausgehen. So lässt sich beispielsweise bei einer industriellen Anlage nicht nur fragen, welche Komponenten sichtbar sind, sondern auch, wie diese räumlich zueinander angeordnet sind oder welche Hinweise das Bild auf den Zustand der Anlage gibt. Auch Informationen aus Dokumenten, Schildern oder Bedienoberflächen lassen sich stärker in ihrem jeweiligen Zusammenhang betrachten.
Besonders interessant ist diese Fähigkeit überall dort, wo Bilder sehr unterschiedlich aussehen und sich Informationsbedürfnisse im Laufe der Zeit verändern. Sprachliche Fragestellungen bieten einen flexibleren Zugang zu visuellen Daten, als es ausschließlich fest vorgegebene Erkennungskategorien ermöglichen. Damit entstehen neue Chancen für die Analyse, Dokumentation und Unterstützung industrieller Prozesse – ohne dass jede mögliche Anwendung bereits im Vorfeld bis ins Detail festgelegt sein muss.
Wo Präzision weiterhin entscheidend ist
Die zusätzlichen Fähigkeiten bedeuten nicht, dass VLMs automatisch jede bisherige Methode übertreffen. Ein Modell kann eine Szene zutreffend beschreiben und trotzdem eine einzelne Ziffer übersehen. Bei einer technischen Identifikationsnummer ist bereits ein falsch erkanntes Zeichen relevant.
Auch bei sehr kleinen Beschriftungen, Unschärfe, wechselnder Beleuchtung oder ungewohnten Perspektiven bleibt die Bildqualität entscheidend. Aktuelle Untersuchungen zu multimodaler Texterkennung und Robustheit machen deutlich, dass solche Herausforderungen weiterhin bestehen. [9–12]
Hinzu kommt: Ein generatives Modell kann eine überzeugende, aber unzutreffende Antwort formulieren – etwa eine Eigenschaft nennen, die auf dem Bild gar nicht zu erkennen ist. Dieses Phänomen wird als Halluzination bezeichnet. Deshalb sollten technische Aussagen, auf die sich weitere Prozesse verlassen, überprüfbar bleiben. [9]
Schließlich ist die Verarbeitung eines größeren Modells oft rechenintensiver als die eines kleinen, auf eine bestimmte Aufgabe optimierten Erkennungsnetzes. In zeitkritischen Anwendungen oder auf Geräten mit begrenzter Rechenleistung ist das ein wichtiges Auswahlkriterium. [3, 4]
Ausblick: Die Stärken beider Ansätze verbinden
Die spannendste Perspektive liegt nicht zwangsläufig darin, alle bestehenden Verfahren durch ein einziges Modell zu ersetzen. Vielmehr können spezialisierte Erkennung und flexibles Bildverständnis zusammenarbeiten.
Ein dafür optimiertes Modell könnte weiterhin eine Identifikationsnummer schnell und präzise auslesen. Ein VLM könnte ergänzend Informationen aus unterschiedlichen Bildbereichen zusammenführen, auf neue Fragen reagieren oder ungewöhnliche Situationen beschreiben. Anschließend sorgen technische Prüfungen dafür, dass nur ausreichend verlässliche Angaben in automatisierte Prozesse übernommen werden.
Damit entwickelt sich Computer Vision von der Erkennung einzelner Merkmale hin zur kontextbezogenen Gewinnung visueller Informationen. Für die Industrie ist das eine besonders interessante Perspektive: Kamerabilder werden nicht nur zu einer Quelle einzelner Messwerte oder Kennungen, sondern können zunehmend flexibel nach den Informationen ausgewertet werden, die ein Prozess tatsächlich benötigt.
Vision-Language-Modelle sind damit kein Abschied von klassischer Bildverarbeitung. Sie sind der nächste Schritt hin zu Systemen, die mehr aus Bildern erschließen können – und gemeinsam mit spezialisierten Verfahren neue Möglichkeiten für die industrielle Automatisierung eröffnen.
Referenzen
¹Dosovitskiy, A. et al. (2021). An Image Is Worth 16×16 Words: Transformers for Image Recognition at Scale. ICLR. https://arxiv.org/abs/2010.11929
²Radford, A. et al. (2021). Learning Transferable Visual Models From Natural Language Supervision. ICML. https://arxiv.org/abs/2103.00020
³Li, J. et al. (2023). BLIP-2: Bootstrapping Language-Image Pre-training with Frozen Image Encoders and Large Language Models. ICML. https://arxiv.org/abs/2301.12597
⁴Liu, H. et al. (2023). Visual Instruction Tuning. NeurIPS. https://arxiv.org/abs/2304.08485
⁵Shi, B., Bai, X. & Yao, C. (2017). An End-to-End Trainable Neural Network for Image-Based Sequence Recognition and Its Application to Scene Text Recognition. IEEE TPAMI. https://doi.org/10.1109/TPAMI.2016.2646371
⁶Singh, A. et al. (2019). Towards VQA Models That Can Read. CVPR. https://arxiv.org/abs/1904.08920
⁷Kim, G. et al. (2022). OCR-free Document Understanding Transformer. ECCV. https://arxiv.org/abs/2111.15664
⁸Minderer, M. et al. (2022). Simple Open-Vocabulary Object Detection with Vision Transformers. ECCV. https://arxiv.org/abs/2205.06230
⁹Li, Y. et al. (2023). Evaluating Object Hallucination in Large Vision-Language Models. EMNLP. https://arxiv.org/abs/2305.10355
¹⁰Fu, L. et al. (2025). OCRBench v2: An Improved Benchmark for Evaluating Large Multimodal Models on Visual Text Localization and Reasoning. NeurIPS. https://arxiv.org/abs/2501.00321
¹¹Shi, B. et al. (2025). Scaling Vision Pre-Training to 4K Resolution. CVPR. https://arxiv.org/abs/2503.19903
¹²Saxena, R., Suglia, A. & Minervini, P. (2026). VLM-RobustBench: A Comprehensive Benchmark for Robustness of Vision-Language Models. https://arxiv.org/abs/2603.06148